
„Prüfen Sie die KI-Ergebnisse kritisch!“ Dieser Satz gehört an vielen Hochschulen inzwischen zum Standardrepertoire. Er klingt vernünftig, bleibt aber folgenlos, solange nicht klar ist, was eigentlich geprüft werden soll und wie das konkret zu machen ist. Wer eine kritische Prüfung einfordert, sollte sich deshalb an drei Fragen orientieren: Existiert die Quelle? Trägt sie die Aussage? Und welche Daten und Literatur fehlen möglicherweise?
Es wird sich zeigen, dass die Antwort auf diese Fragen gar nicht so leicht ist.
1. Existiert die Quelle überhaupt?
Große Sprachmodelle können Literaturangaben erzeugen, die täuschend echt aussehen, aber nicht existieren. Daten zeigen einen massiven Anstieg solcher Halluzinationen in allen Disziplinen und Publikationsformen: von studentischen Abschlussarbeiten bis hin zu Studien in renommierten Peer-Review-Zeitschriften (Topaz et al., 2026; Zhao et al., 2026).
Die von der KI fabrizierten Referenzen werden oft nicht erkannt und von anderen zitiert, wodurch sie Teil des wissenschaftlichen Ökosystems werden und Legitimität gewinnen. Ein Beispiel: 2026 entdeckte der Bildungsforscher Olaf Zawacki-Richter eine ihm zugeschriebene Studie, die nicht existierte. Sie war bereits von 72 weiteren Publikationen zitiert worden (Thomas, 2026).
Die erste Prüffrage lautet deshalb: Gibt es die Quelle wirklich? Keine erfundene Quelle hätte diese Prüfstufe bestanden, wenn jemand den Link geöffnet und die Angabe mit dem Dokument oder einem Katalogeintrag abgeglichen hätte.
Woher die erfundenen Quellen kommen
Sprachmodelle sind Wahrscheinlichkeits-Maschinen, keine Wahrheits-Erzeuger. Sie basieren auf statistischen Berechnungen. Reichen ihre gelernten Muster für eine Antwort nicht aus, erzeugt das Modell trotzdem eine plausible Fortsetzung. Raten wird durch die Trainings- und Bewertungsverfahren eher belohnt, als keine Antwort zu geben. So können Halluzinationen entstehen.
Dass erfundene Quellen in wissenschaftliche Arbeiten gelangen, ist aber nicht allein ein technisches Problem, sondern auch das Ergebnis einer schlecht angelegten Suche. Denn die meisten Studierenden und Lehrenden nutzen für ihre Daten- und Literaturrecherche Allzweck-KIs, allen voran ChatGPT (Bosse et al., 2026). Besser wäre es, für eine Suche KI-Tools zu nutzen, die auf wissenschaftliche Datenbestände zugreifen und ihre Ergebnisse mit real existierenden Quellen verknüpfen. Das verringert das Risiko erfundener Literaturangaben deutlich.
Ein verbreitetes Verfahren dafür ist Retrieval-Augmented Generation (RAG). Vereinfacht gesagt, sucht das System zunächst relevante Dokumente in einem angebundenen Datenbestand, danach generiert ein Sprachmodell auf Basis dieser Dokumente eine Antwort. Solche KI-Systeme finden sich an Hochschulen in Form von KI-gestützten Fachdatenbanken wie Scopus AI, der EBSCOhost Natural Language Search oder dem wiso-net KI-Assistenten. Auch KI-gestützte wissenschaftliche Suchmaschinen wie Google Scholar Labs oder der Preprint-Server alphaXiv nutzen dieses System. Zudem gibt es inzwischen mehr als 50 eigenständige wissenschaftsspezifische KI-Recherche-Tools wie scienceOS, Elicit oder Consensus.
Doppelte Prüfpflicht
ChatGPT und Claude können über Plugins und Konnektoren mit einigen dieser Tools und Datenbanken verbunden und durch Recherche-Skills und Deep-Research-Modi verbessert werden. Nur in dieser Form sollten sie zur wissenschaftlichen Suche genutzt werden (Walther, 2026). Doch auch dann gilt: Alle Quellen öffnen und die bibliografischen Angaben prüfen.
Lehrende sollten diese Suchmöglichkeiten ihren Studierenden zeigen und dabei zwei Dinge klar machen. Erstens: Halluzinationen sind kein technischer Unfall, sondern das Ergebnis einer schlecht angelegten Recherche. Zweitens: Wer eine KI-generierte Quelle ungeprüft übernimmt, verfehlt einen Grundstandard wissenschaftlichen Arbeitens.
Daraus folgt eine doppelte Prüfpflicht: Studierende prüfen ihre Quellen. Lehrende prüfen, ob geprüft wurde. Bei Literaturverzeichnissen helfen Werkzeuge wie BibFox oder spezielle Prüf-Skills, halluzinierte Referenzen und andere fehlerhafte Angaben automatisch zu finden.
2. Stützt die Quelle wirklich die Aussage?
Eine Studie kann existieren und trotzdem von der KI fehlerhaft wiedergegeben werden. KI-Systeme neigen dazu, Ergebnisse zu verallgemeinern oder Informationen bei der wiederholten Bearbeitung von Dokumenten zu verfälschen (Laban et al., 2026; Peters & Chin-Yee, 2025). Geprüft werden muss deshalb auch die Verbindung zwischen Behauptung und Beleg. Lehrende können ihren Studierenden z. B. eine Quelle und eine von der KI dazu generierte Aussage vorlegen und sie einem von drei Fällen zuordnen lassen:
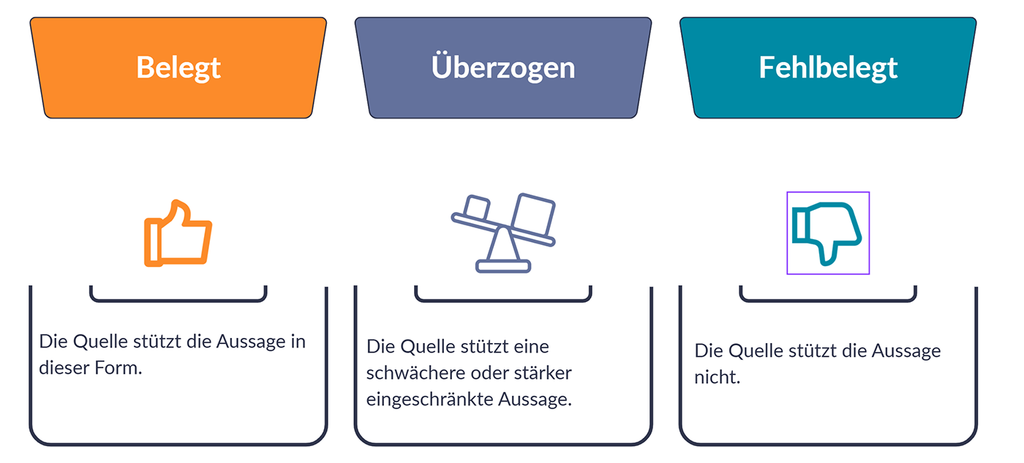
Diese Prüfung ist auch deshalb wichtig, weil immer mehr Studierende bei einer Suche nur noch die KI-Antwort lesen und nicht mehr in die Quelle schauen (Walther, 2026). Zudem sollten auch das Studiendesign, die Messinstrumente und weitere Kriterien geprüft werden, um die Aussagekraft und den Geltungsbereich einer Studie bestimmen zu können. KI-Systeme können dabei helfen, indem sie Evidenzmatrizen erstellen, die für jede gefundene Studie Methode, Ergebnis, Einschränkungen usw. angeben.
Der Prompt entscheidet über den Suchraum
Damit das gelingt, braucht es gute Prompts. Daran mangelt es aber. Zum einen, weil auch schlechte Prompts gut klingende Ergebnisse liefern. Zum anderen, weil es den meisten Studierenden und Lehrenden an fundierter KI-Bildung im Allgemeinen und Prompting-Kenntnissen im Speziellen mangelt. Eine groß angelegte Messung zeigte, dass von 5.000 Forschenden in Deutschland nur 21 % eine Prompting-Aufgabe erfolgreich absolvieren konnten (Chugunova et al., 2026).
An dieser Stelle deshalb ein Beispiel. Sucht man Literatur zu der Frage, ob der KI-Einsatz bei Studierenden Kompetenzverluste (sog. Deskilling) mit sich bringt, genügt es nicht zu prompten: „Führt der Einsatz von KI bei Studierenden zu Kompetenzverlust?“
Besser wäre es, den Prompt so zu formulieren:
„Recherchiere empirische Literatur (2023-2026) zu Deskilling, Downskilling und Cognitive Offloading durch KI im Hochschulbereich. Prüfe in diesem Kontext Veränderungen von Schreib-, Recherche-, Problemlöse-, Metakognitions- und Critical-Thinking-Kompetenzen. Priorisiere europäische Studien, besonders aus dem DACH-Raum, und ergänze sie um internationale Evidenz. Erfasse quantitative, qualitative und Mixed-Methods-Studien sowie relevante Reports, Meta-Analysen und systematische Übersichtsarbeiten. Erstelle eine Evidenzmatrix mit Studiendesign, Stichprobe, Ergebnissen, Evidenzstärke und Limitationen. Trenne konsequent zwischen gemessenen Kompetenzveränderungen, wahrgenommenen Effekten und bloßen Einstellungen gegenüber KI. Identifiziere Forschungslücken und leite Implikationen für Hochschulen ab.“
Kurzum: Ein guter Prompt klärt Begriffe, operationalisiert die Forschungsfrage, legt Ein- und Ausschlüsse fest und definiert die gewünschte Form des Ergebnisses.
Die ersten zwei Ebenen der Prüfung wären damit beschrieben. Doch es fehlt noch eine dritte, die den beiden anderen eigentlich vorausgeht.
3. Was zeigt die Antwort nicht?
Nehmen wir an, alle von der KI angegebenen Quellen existieren, sind korrekt wiedergegeben und analysiert. Ist die Antwort damit wissenschaftlich belastbar? Nicht unbedingt, denn kein Recherche-System bildet die Datenlage zu einem Thema umfassend ab. Die dritte Frage lautet deshalb: Welche relevanten Quellen, Gegenbefunde oder Perspektiven fehlen?
Alle Recherchesysteme haben Einschränkungen, auch solche, die ohne KI arbeiten. Traditionelle Suchsysteme wie OPACs beeinflussen vor allem, welche Literatur wir finden. Generative KI geht einen Schritt weiter: Sie wählt die Quellen nicht nur aus, sondern verknüpft und interpretiert auch ihre Inhalte. Das Ergebnis erscheint dabei oft gut strukturiert und so klar, dass es nur selten geprüft wird. Verzerrungen sind dadurch umso schwerer zu erkennen.
Solche Biases stecken in jedem KI-System. Welche sich zeigen, hängt vom Datenbestand und der Suchlogik des Systems ab. Je nach KI-Tool können z. B. englischsprachige Zeitschriftenartikel überrepräsentiert sein, während deutschsprachige Studien, Monografien oder geisteswissenschaftliche Forschung seltener gefunden werden. Was in den zugrunde liegenden Datenbeständen fehlt oder schlecht erschlossen ist, findet sich deshalb auch in der KI-Antwort kaum oder gar nicht wieder.
Datenbestände kennen, Suchfunktionen verstehen, Leerstellen finden
Die Prüffrage lautet deshalb: Ist der Forschungsstand hinreichend breit und nachvollziehbar recherchiert? Die Antwort darauf setzt neben Informationskompetenz auch KI-Bildung voraus, denn wer Lücken erkennen will, muss wissen, wie die Antwort entstanden ist:
- Auf welchen Datenbeständen basiert ein KI-System?
- Nutzt es zur Suche nur bibliografische Angaben und Abstracts oder auch Volltexte?
- Wie liest, gewichtet und sortiert es die Quellen?
Die Antwort auf diese Fragen macht klar, was ein Recherchesystem überhaupt finden kann und was außerhalb seines Suchraums liegt. Darüber hinaus wird der Suchraum durch die Fragestellung bzw. den Prompt, die darin verwendeten Begriffe sowie weitere Prompt-Eingaben bestimmt. Prüfen Sie deshalb auf zwei Ebenen.
1.) Im selben System: Schon kleine Änderungen am Prompt führen zu anderen Treffern. Variieren Sie deshalb systematisch Suchbegriffe und Perspektiven, dokumentieren Sie die Ergebnisse und vergleichen Sie sie, gern auch mit Hilfe von KI. So lässt sich prüfen, welche Prompts die besten Resultate liefern und warum das so ist.
2.) Über die Systeme hinweg: Recherchesysteme unterscheiden sich in ihrer Datenbasis und Funktionsweise: Bibliothekskataloge, Fachdatenbanken, akademische Suchmaschinen, Preprint-Server, Repositorien und KI-Tools finden je andere Daten und Literatur. Recherchieren Sie deshalb in verschiedenen Systemen und suchen Sie, z. B. mit Hilfe eines entsprechenden Prompts, gezielt nach Gegenbefunden. Nur so wird aus dem „Prüfen“ ein „kritisches Prüfen“.
Aus einem einfachen Satz wird eine anspruchsvolle Kompetenz
Wenn die vielfach geforderte Prüfung von KI-Ergebnissen etwas bringen soll, darf sie keine abstrakte Aufgabe bleiben, sondern muss in konkrete Handlungen übersetzt werden: Quellen nachweisen, Aussagen und Belege vergleichen, Forschungsstände recherchieren und verschiedene Suchsysteme nutzen.
Dabei zeigt sich, dass zwischen den verschiedenen Prüfebenen und -punkten qualitative Unterschiede bestehen: Eine Quellenangabe lässt sich schnell kontrollieren. Eine Evidenzprüfung ist schon komplexer. Und das Sichtbarmachen und Erkennen möglicher Verzerrungen und Lücken in einer KI-Antwort bzw. einem Forschungsstand ist die wohl anspruchsvollste Aufgabe, denn sie verlangt neben Fachwissen eine fundierte KI-Bildung und umfassende Informationskompetenz.
Kritisches Prüfen darf jedoch nicht nur von Studierenden verlangt, sondern muss von den Lehrenden vorgelebt und vermittelt werden. Lehrende müssen zeigen können, was auf welcher Ebene geprüft wird, wie diese Prüfung funktioniert und wo ihre Grenzen liegen. Das Problem: Genau diese Kompetenzen sind an den Hochschulen noch nicht ausreichend verbreitet (Walther, 2026). Man könnte daher einwenden: Wie sollen Lehrende das leisten, wenn ihnen selbst noch KI-Bildung fehlt? Meine Antwort: Sie müssen nicht warten, bis Sie alles wissen. Entwickeln Sie Ihre Lehre zusammen mit Ihren Studierenden weiter. Formulieren, testen und überarbeiten Sie Kriterien und benennen Sie Ihre eigenen Wissenslücken dabei ganz offen. Denn eines ist klar: Kritisches Prüfen lässt sich lernen und lehren.
Transparenzhinweis
- Formulierung einzelner Sätze: Claude Opus 4.8
- Titelbild: denis1203, de.123rf.com
- Bild “Spotlights”: olegtroino, de.123rf.com
- Infografik: erstellt mit Canva
Literatur
Bosse, E., Wannemacher, K., & Lübcke, M. (2026). Die KI-Nutzung in Studium und Lehre: Ein Review auf Grundlage empirischer Studien (Arbeitspapier Nr. 91). Hochschulforum Digitalisierung. https://doi.org/10.5281/zenodo.18403399
Chugunova, M., Harhoff, D., Hölzle, K., Kaschub, V., Malagimani, S., Morgalla, U., & Rose, R. (2026). Who uses AI in research, and for what? Large-scale survey evidence from Germany. Research Policy, 55(2), Article 105381. https://doi.org/10.1016/j.respol.2025.105381
Laban, P., Schnabel, T., & Neville, J. (2026). LLMs corrupt your documents when you delegate. arXiv. https://doi.org/10.48550/arXiv.2604.15597
Peters, U., & Chin-Yee, B. (2025). Generalization bias in large language model summarization of scientific research. Royal Society Open Science, 12(4), Article 241776. https://doi.org/10.1098/rsos.241776
Thomas, R. (2026, September 1). Scholar slop? How hallucinated research citations pollute crucial academic databases. Straight Arrow News. https://san.com/cc/scholar-slop-how-hallucinated-research-citations-pollute-crucial-academic-databases/
Topaz, M., Roguin, N., Gupta, P., Zhang, Z., & Peltonen, L.-M. (2026). Fabricated citations: An audit across 2.5 million biomedical papers. The Lancet, 407(10541), 1779–1781. https://doi.org/10.1016/S0140-6736(26)00603-3
Walther, D. (2026). Vom Google-Dilemma zum KI-Dilemma? Sechs Thesen zur Recherche- und Informationskompetenz an Hochschulen im Angesicht von KI [Arbeitspapier]. Zenodo. https://doi.org/10.5281/zenodo.22179213
Zhao, Z., Wang, Y., Stuart, T., De Vaan, M., Ginsparg, P., & Yin, Y. (2026). LLM hallucinations in the wild: Large-scale evidence from non-existent citations. arXiv. https://doi.org/10.48550/arXiv.2605.07723
Vorschlag zur Zitation
Walther, D. (2026, 15. Oktober). KI-Ergebnisse kritisch prüfen: Was es bedeutet, was es verlangt, wie es geht. Lehrblick – ZHW Uni Regensburg. https://doi.org/10.5283/ZHW.20261015.DE
Danny Walther
Danny Walther ist als freier Dozent an Hochschulen, Bildungs- und Forschungseinrichtungen tätig. Er veranstaltet Workshops und Webinare zum Einsatz von Künstlicher Intelligenz in Wissenschaft und Studium. Seine Schwerpunkte sind die Daten- und Literaturrecherche, Visualisierungs-Methoden und die Frage, wie Studieren, Lehren und Forschen im KI-Zeitalter gelingen kann. Das Ziel seiner Arbeit ist ein praxisnaher und wissenschaftlich fundierter Umgang mit KI.
https://www.linkedin.com/in/ki-recherchen/